Como ler CSV com ponto e vírgula e vírgula decimal em Python
Leia CSV com ponto e vírgula e vírgula decimal em Python. Valide datas, campos e duplicidades e gere um resumo com resultados conferidos.
Equipe Próxima Habilidade · Atualizado em 2026-10-10 · 16 min de leitura
Neste artigo
- Defina o resultado antes de escrever o programa
- Entenda o contrato do arquivo
- Crie a entrada de demonstração
- Faça uma leitura mínima antes de calcular
- Converta valores por uma regra explícita
- Valide a estrutura antes de confiar nos registros
- Programa completo: ler, conferir, resumir e escrever
- Confira a saída com um gabarito independente
- Provoque erros controlados para aprender o diagnóstico
- Evite soluções que escondem a causa
- Quando ampliar a solução
- Exercício final e critérios de conclusão
- Fontes e conferência
Para ler um CSV brasileiro em Python, abra o arquivo com a codificação conhecida, use csv.DictReader com delimiter=";" e converta os valores decimais explicitamente. No exemplo deste guia, Decimal("120,50".replace(",", ".")) representa 120,50 para os cálculos. Antes de somar, valide cabeçalhos, campos obrigatórios, datas e identificadores repetidos. Um arquivo que abriu sem erro ainda pode conter dados inadequados para o relatório.
Você vai construir um programa que lê cinco lançamentos fictícios, seleciona outubro de 2026 e gera um resumo por categoria. O exercício utiliza somente a biblioteca padrão e foi conferido em Python 3.12.14. Não é necessário instalar pandas. O programa não acessa contas, sites ou sistemas financeiros; lê um arquivo de demonstração em uma pasta local. A habilidade ensinada é transformar uma exportação tabular em uma resposta verificável, preservando o arquivo de origem.
Defina o resultado antes de escrever o programa
A pergunta da atividade é: quanto foi lançado em cada categoria durante outubro de 2026? Não estamos calculando lucro, saldo bancário ou impostos. Os valores são registros didáticos que serão somados por uma regra explícita. Essa definição limita o trabalho: precisamos identificar a categoria, interpretar o valor e verificar a data. Outras análises, como conciliar pagamentos ou avaliar a origem dos lançamentos, exigiriam dados e regras adicionais.
O resultado esperado é um CSV novo com categoria, quantidade de registros e total. Vamos manter a exportação original e escrever a saída em outro arquivo. Essa separação permite repetir a leitura e comparar o resultado com a fonte. Evite começar alterando manualmente o arquivo recebido para fazer o código funcionar. Uma correção invisível na entrada pode transformar o relatório em algo que ninguém consegue reproduzir depois.
Se você já estuda planilhas, relacione este exercício com a ideia de uma base organizada no guia de Excel do zero. A pergunta é semelhante, mas o processo será expresso em código. Para escolher quando usar uma planilha ou ampliar o tratamento dos dados, consulte Excel ou Power BI. Não é preciso substituir ferramentas que já resolvem a tarefa; vale aprender a leitura programática quando ela atende uma necessidade concreta.
Entenda o contrato do arquivo
CSV é um formato de texto tabular. Neste exercício, os campos são separados por ponto e vírgula; os valores usam vírgula decimal; as datas seguem dia, mês e ano; e o texto está em UTF-8. Essas escolhas formam o contrato da entrada. Um arquivo de outro sistema pode usar vírgulas como separador, ponto decimal e outro formato de data. A extensão .csv, sozinha, não informa todas essas decisões.
A documentação do módulo csv descreve leitores que interpretam separadores e aspas, inclusive DictReader, que associa os campos aos nomes do cabeçalho. Por isso, não vamos quebrar cada linha usando split(";"). Uma observação pode conter ponto e vírgula entre aspas sem iniciar uma nova coluna. A presença desse caractere dentro do texto faz parte do formato e deve ser tratada pelo leitor apropriado.
Também não vamos pedir que o programa adivinhe tudo automaticamente. Para um primeiro processo, configure um formato conhecido e rejeite o que não corresponde a ele. Um arquivo com separador diferente deve produzir uma investigação, não uma tentativa silenciosa de reinterpretar informações. Depois que você dominar a entrada controlada, poderá projetar uma rotina para várias fontes. Começar com essa generalização aumenta a quantidade de decisões antes de existir uma resposta pequena e conferida.
Crie a entrada de demonstração
Crie uma pasta para a atividade e, em um editor de texto, salve o conteúdo abaixo como lancamentos.csv, em UTF-8. Todos os registros são fictícios. Não acrescente uma linha de total, não troque os nomes do cabeçalho e não inclua o símbolo R$ nos valores. A observação da primeira linha contém um ponto e vírgula protegido por aspas, justamente para demonstrar por que a leitura precisa respeitar o formato.
id;data;categoria;valor;observacao
L001;01/10/2026;Curso;120,50;"Turma da manhã; primeira parcela"
L002;02/10/2026;Material;35,00;Papel
L003;10/10/2026;Curso;45,25;Oficina
L004;31/10/2026;Material;100,00;Kit
L005;01/11/2026;Curso;80,00;Turma de novembro
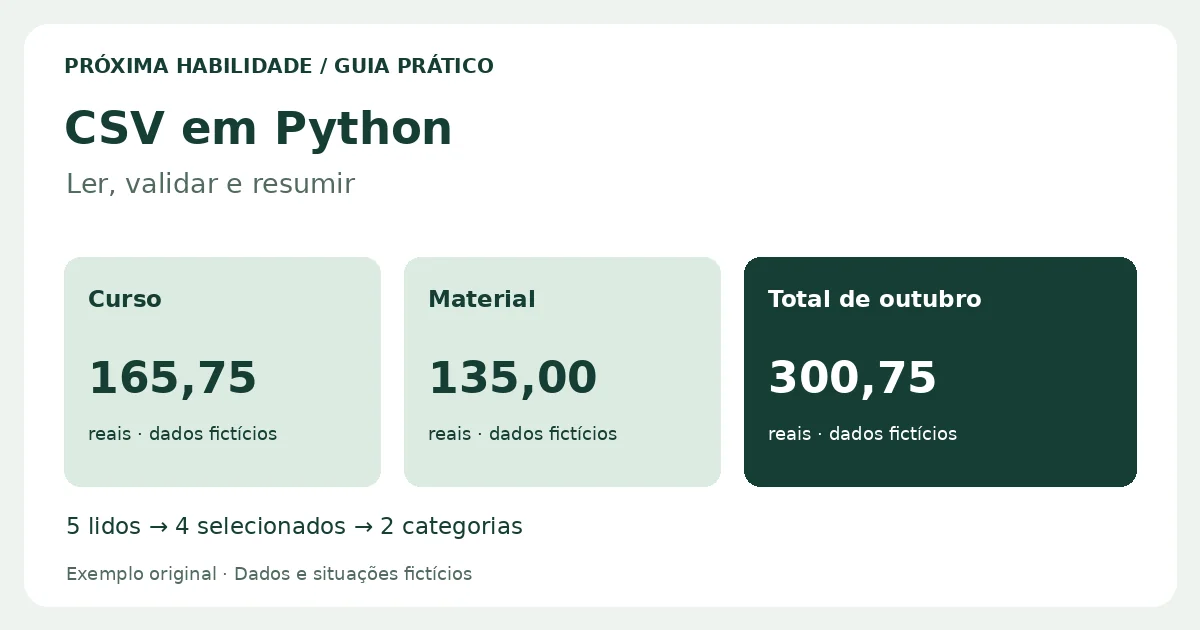
Confira o exemplo antes do código. Em outubro, Curso tem 120,50 mais 45,25, totalizando 165,75. Material tem 35,00 mais 100,00, totalizando 135,00. A soma de outubro é 300,75. O último registro pertence a novembro e fica fora da seleção. Se você somar todos os cinco registros, encontrará 380,75. Esses dois totais respondem a perguntas diferentes, e a diferença de 80,00 é uma verificação útil do filtro.
Abra o arquivo em um editor que mostre texto simples. Se uma planilha transformar datas ou códigos ao salvar, confira a exportação novamente. O que o programa lê é o conteúdo efetivo do arquivo, não a aparência na aplicação que o gerou. Nesta atividade, o identificador L001 deve permanecer como texto, e o valor deve continuar escrito com duas casas decimais. Não há necessidade de adicionar dados reais para aprender o processo.
Faça uma leitura mínima antes de calcular
Salve o trecho abaixo como conferir_leitura.py na mesma pasta. Execute-o pelo terminal usando o comando que inicia seu Python, por exemplo python3 conferir_leitura.py ou python conferir_leitura.py. Os nomes de comandos dependem da instalação; confira a versão com python3 --version ou o equivalente disponível. Esta etapa mostra os campos recebidos sem gerar nenhum relatório e sem modificar a entrada.
import csv

with open("lancamentos.csv", encoding="utf-8-sig", newline="") as arquivo:
    leitor = csv.DictReader(arquivo, delimiter=";", strict=True)
    print(leitor.fieldnames)
    for registro in leitor:
        print(registro["id"], registro["valor"], registro["observacao"])
O cabeçalho deve apresentar os cinco nomes definidos. A primeira observação deve aparecer inteira, com o ponto e vírgula dentro do texto. Se aparecer uma única coluna chamada id;data;categoria;valor;observacao, o separador não foi configurado corretamente. Se uma chave não for encontrada, investigue o cabeçalho antes de alterar a soma. A leitura mínima permite localizar problemas de estrutura sem misturá-los com conversão de datas, valores e agrupamento.
O uso de newline="" acompanha a orientação do módulo csv. A codificação utf-8-sig permite ler UTF-8 com ou sem o marcador inicial conhecido como BOM, conforme a documentação de codecs. Ela não resolve todos os arquivos de outras codificações. Se houver UnicodeDecodeError, confirme como o sistema exportou o texto. Não use descarte de caracteres como solução automática: perder letras pode modificar categorias e identificadores.
Converta valores por uma regra explícita
No nosso contrato, 120,50 é um valor válido e 1.200,50 ainda não é. Vamos aceitar apenas números positivos com vírgula e duas casas decimais, sem separador de milhares. Isso torna a conversão previsível. Remover todos os pontos indiscriminadamente seria perigoso se outro arquivo já usasse ponto decimal. A transformação precisa corresponder ao formato declarado. Quando a entrada mudar, atualize o contrato e os casos de conferência antes do código.
Usaremos Decimal a partir de texto, como indicado pela documentação de aritmética decimal. O exemplo evita passar por float na conversão. Para os valores curtos e somas desta atividade, podemos trabalhar com os centavos apresentados e verificar o total diretamente. Um processo real com cálculos financeiros adicionais precisaria definir precisão, arredondamento e significado de cada valor. Aqui, a tarefa é uma soma simples de lançamentos fictícios.
Mantenha distinto o valor para cálculo e o texto para exibição. Internamente, Decimal recebe 120.50; na saída brasileira, o programa apresenta 120,50. Se você colocar R$ junto ao número durante a leitura, terá de criar outra regra para separar a moeda. Por enquanto, a coluna valor representa uma unidade monetária única, descrita nas instruções. Não misture moedas ou unidades na mesma soma sem uma decisão específica sobre como compará-las.
Valide a estrutura antes de confiar nos registros
O programa completo exigirá exatamente cinco cabeçalhos, sem repetições. Também verificará se uma linha trouxe campos a mais ou a menos e se um campo obrigatório ficou vazio. A coluna de observação poderá ficar em branco. Não tratar essas situações pode fazer um valor cair na coluna errada ou permitir que um lançamento incompleto participe do resumo. Uma falha clara na validação é preferível a um arquivo final aparentemente bem organizado, mas sem significado.
Vamos rejeitar identificadores repetidos em toda a entrada, inclusive fora de outubro. Isso corresponde à regra escolhida para o exercício: cada id identifica um lançamento. Em outra fonte, um documento poderia aparecer legitimamente em vários itens; nesse caso, seria necessário escolher outra chave. Não remova duplicatas apenas pela igualdade do valor ou da categoria. Dois lançamentos de 35,00 podem ser eventos diferentes, e uma exclusão indevida altera o relatório.
As datas serão interpretadas com datetime.strptime, explicado na documentação de datetime. Além de pedir o formato dia/mês/ano, o programa exige a aparência com dois dígitos para dia e mês e quatro para ano. Uma data impossível, como 31/02/2026, será rejeitada. O filtro compara ano e mês do objeto interpretado. Assim, não depende de um pedaço de texto parecido com outubro dentro de uma observação.
Programa completo: ler, conferir, resumir e escrever
Salve o programa abaixo como resumir_csv.py. Ele utiliza os arquivos da pasta em que você inicia o comando. Execute primeiro com a entrada de demonstração e sem um arquivo resumo.csv existente. A abertura da saída usa o modo x, que impede sobrescrever um resultado anterior. Para repetir a atividade, guarde ou renomeie a saída e só então execute novamente. O programa não apaga nem substitui o arquivo de origem.
import csv
import re
from collections import defaultdict
from datetime import datetime
from decimal import Decimal
from pathlib import Path

ENTRADA = Path("lancamentos.csv")
SAIDA = Path("resumo.csv")
CABECALHOS = ["id", "data", "categoria", "valor", "observacao"]
ANO, MES = 2026, 10

totais = defaultdict(lambda: Decimal("0.00"))
quantidades = defaultdict(int)
ids = set()
lidos = selecionados = 0

with ENTRADA.open(encoding="utf-8-sig", newline="") as arquivo:
    leitor = csv.DictReader(arquivo, delimiter=";", strict=True)
    campos = leitor.fieldnames
    if campos is None or len(campos) != len(set(campos)):
        raise ValueError("Cabeçalho ausente ou repetido")
    if set(campos) != set(CABECALHOS):
        raise ValueError("Cabeçalho diferente do contrato esperado")

    for registro in leitor:
        local = f"linha física {leitor.line_num}"
        if None in registro or any(v is None for v in registro.values()):
            raise ValueError(f"{local}: quantidade de campos incorreta")
        registro = {k: v.strip() for k, v in registro.items()}
        obrigatorios = ["id", "data", "categoria", "valor"]
        if any(not registro[k] for k in obrigatorios):
            raise ValueError(f"{local}: campo obrigatório vazio")
        identificador = registro["id"]
        if identificador in ids:
            raise ValueError(f"{local}: identificador repetido")
        ids.add(identificador)

        if not re.fullmatch(r"[0-9]{2}/[0-9]{2}/[0-9]{4}", registro["data"]):
            raise ValueError(f"{local}: formato de data inválido")
        try:
            data = datetime.strptime(registro["data"], "%d/%m/%Y").date()
        except ValueError as erro:
            raise ValueError(f"{local}: data impossível") from erro

        if not re.fullmatch(r"[0-9]+,[0-9]{2}", registro["valor"]):
            raise ValueError(f"{local}: valor fora do formato 120,50")
        valor = Decimal(registro["valor"].replace(",", "."))
        if valor <= 0:
            raise ValueError(f"{local}: valor deve ser positivo")

        lidos += 1
        if (data.year, data.month) != (ANO, MES):
            continue
        categoria = registro["categoria"]
        totais[categoria] += valor
        quantidades[categoria] += 1
        selecionados += 1

with SAIDA.open("x", encoding="utf-8-sig", newline="") as arquivo:
    escritor = csv.DictWriter(
        arquivo,
        fieldnames=["categoria", "quantidade", "total"],
        delimiter=";",
    )
    escritor.writeheader()
    for categoria in sorted(totais):
        escritor.writerow({
            "categoria": categoria,
            "quantidade": quantidades[categoria],
            "total": f"{totais[categoria]:.2f}".replace(".", ","),
        })

geral = sum(totais.values(), Decimal("0.00"))
print(f"Registros lidos: {lidos}; selecionados: {selecionados}")
print("Total selecionado:", f"{geral:.2f}".replace(".", ","))
print("Resumo criado em:", SAIDA.resolve())
O programa valida todos os registros antes de abrir a saída. Se um lançamento de novembro estiver malformado, ele também interrompe a execução. Essa é uma escolha do exercício: um resumo só será gerado a partir de uma entrada inteiramente válida. Em um fluxo diferente, você poderia separar rejeições e dados aceitos, mas precisaria informar quantos registros ficaram de fora e por quê. Ignorar erros silenciosamente prejudica a conferência.
A indicação linha física ajuda a localizar problemas no texto. Em CSV, um registro entre aspas pode ocupar mais de uma linha física, portanto esse número não é necessariamente a posição do lançamento na tabela. O leitor fornece a linha alcançada durante a leitura. Para rastreamento em uma rotina maior, guarde também o identificador e uma descrição do problema, evitando incluir dados pessoais desnecessários em mensagens ou relatórios de erro.
Confira a saída com um gabarito independente
A execução correta informa cinco registros lidos e quatro selecionados, com total 300,75. O arquivo resumo.csv deve conter Curso com quantidade 2 e total 165,75, e Material com quantidade 2 e total 135,00. A ordenação alfabética facilita comparar execuções, mas não altera os cálculos. Abra a saída como texto e confira os nomes e separadores. Não dependa apenas de uma planilha que possa reinterpretar automaticamente os campos.
categoria;quantidade;total
Curso;2;165,75
Material;2;135,00
Uma conferência independente usa o cálculo manual apresentado antes do código. Contar as quatro linhas de outubro e somar seus valores não reproduz o algoritmo inteiro; verifica a resposta por outro caminho. Se a saída mostrar 380,75, investigue o filtro, porque esse é o total dos cinco registros. Se mostrar apenas 165,75, veja se a categoria Material foi excluída. Os números esperados funcionam como pistas de diagnóstico, não como valores a inserir à força.
Se o resumo ficar vazio, o programa ainda pode ter criado um arquivo com cabeçalho. Leia a quantidade selecionada: zero pode significar que o período escolhido não contém registros, ou que você executou com uma entrada diferente da demonstração. Registre o nome e a versão da fonte utilizada. Para uso recorrente, acrescentar o período e a identificação da entrada ao relatório facilita descobrir quando duas pessoas estão comparando meses ou exportações diferentes.
Provoque erros controlados para aprender o diagnóstico
Faça os testes em cópias da entrada. Primeiro, troque o valor de L002 por 35.00. A validação deve interromper o programa porque a entrada deixou de seguir a vírgula decimal. Não altere o conversor para aceitar qualquer aparência antes de decidir qual formato é permitido. Em seguida, teste uma categoria vazia. O relatório não deve agrupar esse lançamento em uma categoria inventada ou simplesmente excluir a linha sem indicação.
No segundo teste, duplique L001 em outra linha. Mesmo que os valores sejam diferentes, o identificador repetido deve ser rejeitado. Depois, escreva uma data impossível e observe a mensagem. Cada teste altera apenas uma condição, permitindo verificar qual regra está funcionando. Guarde o gabarito original intacto. Se você provocar várias falhas ao mesmo tempo, a primeira interrupção pode esconder outras e tornar a análise confusa.
No terceiro teste, retire as aspas da observação que contém ponto e vírgula. O registro passa a ter campos extras e deve ser recusado. Esse caso mostra que um arquivo com colunas visualmente alinhadas em um editor pode não respeitar o contrato CSV. O leitor apropriado cuida das aspas, mas não conhece a intenção de um texto malformado. Corrija a geração do arquivo ou obtenha uma exportação válida antes de usar o resultado.
Evite soluções que escondem a causa
Não capture todas as exceções para imprimir apenas deu errado. Uma mensagem precisa diferenciar arquivo ausente, codificação incompatível, cabeçalho inadequado e conteúdo inválido. Durante a aprendizagem, uma interrupção com a localização e a regra violada oferece mais informação que um resumo parcial. Quando criar uma interface para outras pessoas, traduza os erros em instruções úteis, sem apagar o motivo técnico necessário para a manutenção do programa.
Também não transforme campo vazio em zero automaticamente. Um valor ausente é desconhecido; zero é um dado específico. Se o sistema de origem permite valores nulos, defina como serão tratados e informe a quantidade deles. O mesmo cuidado vale para devoluções negativas: nosso contrato as rejeita porque o exemplo contém apenas lançamentos positivos. Uma análise de entradas e saídas exigiria uma convenção própria, e não apenas a remoção dessa validação.
Mantenha categorias consistentes. Curso e curso seriam chaves diferentes no programa apresentado. Você pode decidir padronizar maiúsculas, mas precisa verificar se isso corresponde ao significado dos dados e preservar o texto original quando necessário. Evite juntar categorias por uma semelhança que parece óbvia sem consultar a fonte. Uma pequena tabela de correspondências revisada costuma ser mais explicável que transformações amplas espalhadas pelo código.
Quando ampliar a solução
O programa lê registros em sequência e guarda os totais por categoria e os identificadores vistos. O conjunto de ids cresce com a quantidade de lançamentos, portanto esta não é uma promessa de memória constante para qualquer volume. Para entradas muito grandes, pense em armazenamento adequado e verificações por etapas. Primeiro meça uma necessidade real. Adicionar uma biblioteca ou um banco de dados sem uma dificuldade definida aumenta a manutenção sem necessariamente melhorar a resposta.
Vale ampliar o processo quando houver várias fontes, regras de limpeza recorrentes, tabelas relacionadas ou entregas que precisam de histórico. Preserve o contrato, os exemplos e as contagens como parte dessa evolução. A escolha de pandas, SQL ou outra ferramenta deve acompanhar a tarefa, e não substituir a revisão. Um agrupamento feito em poucos comandos ainda pode resumir colunas erradas ou aceitar registros que deveriam ter sido recusados.
Se a próxima entrega for visual, um resumo confiável pode alimentar o estudo de como criar um primeiro dashboard. Faça a passagem sem perder a definição do período e do total. Uma apresentação atraente não resolve um CSV interpretado de forma inadequada. Leve junto as informações necessárias para explicar de onde vieram os números e quais registros participaram deles, especialmente quando alguém usar o gráfico para tomar uma decisão.
Exercício final e critérios de conclusão
Acrescente, em uma cópia válida, L006 em 15/10/2026, categoria Material, valor 14,25 e observação opcional vazia. O novo total de Material deve ser 149,25; o de outubro, 315,00. Agora são seis registros lidos e cinco selecionados. Repita a soma manualmente antes de executar. Depois mude ANO e MES para selecionar novembro: Curso deve apresentar 80,00, com apenas um registro selecionado. As mudanças testam inclusão e escolha de período.
Você concluiu a atividade quando consegue explicar o contrato, localizar um erro de entrada, reproduzir o resumo e conferir a diferença entre registros lidos e selecionados. Guarde o programa junto às instruções e ao gabarito fictício. Para uma próxima tarefa, escolha outra pergunta pequena, como contar lançamentos por dia, e defina novamente a saída esperada. A habilidade cresce quando cada transformação tem um motivo, uma regra explícita e uma forma de conferência.
Fontes e conferência
As referências foram consultadas em 10 de outubro de 2026. O programa e os casos de erro do exercício foram executados em Python 3.12.14; a documentação usada é a série 3.12. As somas foram comparadas com cálculos independentes. A atividade não valida uma exportação real de terceiros nem substitui as regras do sistema que a produziu. Os registros, as categorias e os valores são exclusivamente didáticos.